Un informe de la Web3 Foundation modela lo que pueden saber de una persona común en 24 horas. En Chile, mientras tanto, la Ley 21.719 va camino a su primera prórroga sin que exista la agencia que debe hacerla cumplir.
Hace unos días, la Web3 Foundation publicó un informe que vale la pena leer con calma: Everyday Surveillance: What One Ordinary Day May Reveal About You. La Web3 Foundation es una fundación suiza sin fines de lucro, con sede en Zug, creada por Gavin Wood, cofundador de Ethereum y la persona que acuñó el término Web3 en 2014. El informe trata de responder la pregunta: ¿Qué pueden recolectar, generar o inferir sobre una persona común durante un día normal? Y lo interesante es el alcance: incluye las aplicaciones que uno elige usar y también los sistemas que operan alrededor sin que uno se haya inscrito en nada, como cámaras, lectores de patentes, plataformas escolares o medidores de electricidad.
Para responder la pregunta define seis hogares modelo, tres en Reino Unido y tres en Estados Unidos, los perfiles de esos hogares modelo eran: un soltero de 34 años, una familia con hijos de 8 y 11 años y una viuda de 75 que vive sola. Los siguieron durante 24 horas y contrastaron cada actividad con lo que dicen las políticas de privacidad, los términos de uso, la documentación técnica y las acciones de los reguladores.
Un día normal, miles de registros
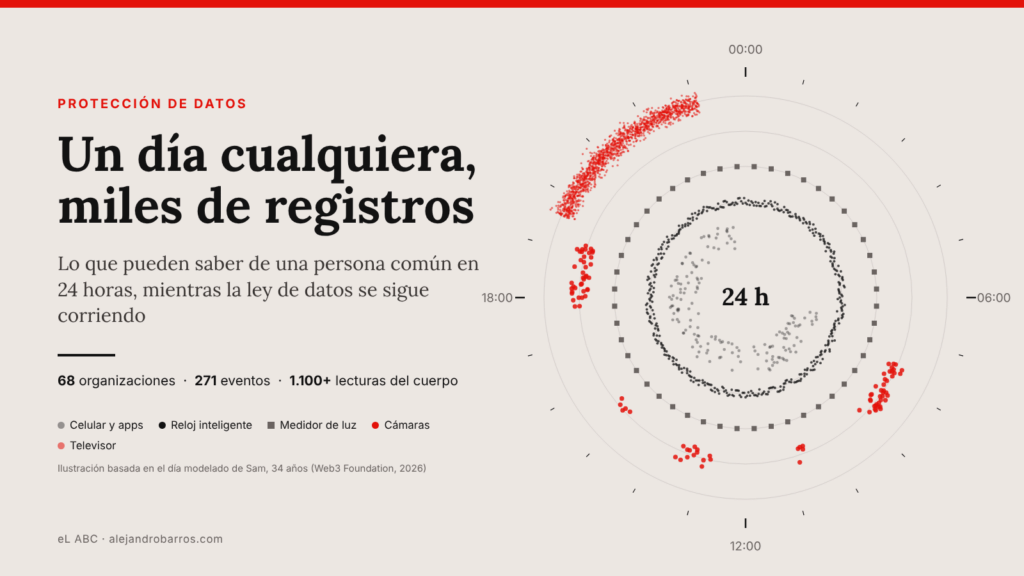
Sam (soltero de 34 años) vive en Manchester, arrienda un departamento de un dormitorio y trabaja en modalidad híbrida. En su día no pasa nada especial: revisa mensajes, va a la oficina, compra, hace ejercicio, ve televisión y se duerme. Ese día queda vinculado a 68 organizaciones, unos 271 eventos de procesamiento de datos, más de 1.100 mediciones de su reloj inteligente y entre 60 y 190 grabaciones de cámaras que no son suyas.
El caso que más me llamó la atención es el de Margaret, la jubilada de 75 años. No usa reloj inteligente ni vive pegada al celular. Pero ve televisión cinco o seis horas al día en un Samsung con reconocimiento automático de contenido, la tecnología que identifica qué aparece en pantalla y lo asocia al hogar. Bajo los supuestos del modelo, eso genera unas 40.000 capturas en un día. Una tarde tranquila frente a la tele puede producir más registros que una hora en redes sociales.
Después están los niños. En la familia modelo de Leeds, 25 de las 88 organizaciones involucradas pueden recoger datos de los hijos. Entre los dos generan unas 100 capturas de cámaras escolares al día, y el sistema de monitoreo del colegio registra 11.400 pulsaciones de teclado a la semana, incluido lo que escribieron y borraron sin enviar. Ninguno de esos niños tiene edad para decidir nada sobre ese historial, que empieza a acumularse años antes de que puedan hacerlo.
Buena parte de todo esto ocurre sin que nadie haya apretado el botón acepto. Uno no firma nada al pasar frente al timbre con cámara del vecino. Un trayecto en auto queda registrado por el celular, por la aplicación de mapas, por el propio auto conectado y por los lectores de patentes, así que apagar una aplicación deja intacto el resto del rastro. Cualquiera que circule por las autopistas urbanas de Santiago con TAG sabe de qué estamos hablando.
Leer los términos y políticas que rigen un solo día de una familia común tomaría 83 horas. Más de diez jornadas laborales completas.
La letra chica como coartada
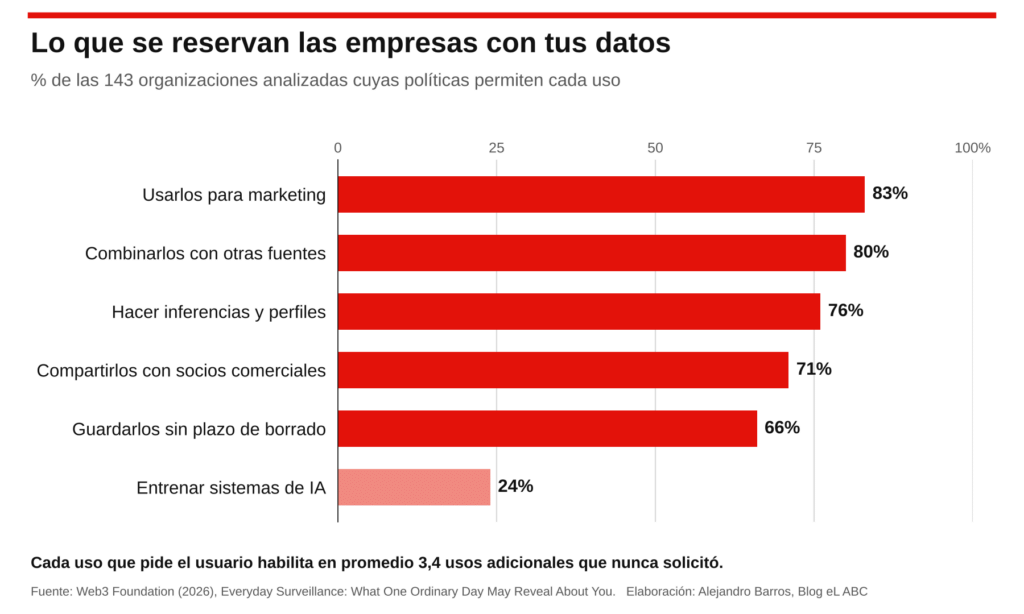
El informe hizo un ejercicio que siempre quise ver cuantificado. Juntaron todos los documentos legales que aplican a cada hogar durante ese único día: 1.195 documentos con más de 5,38 millones de palabras. Leer lo que corresponde a un día de la familia de Leeds tomaría unas 83 horas. Lo que dicen esos documentos es bastante revelador.
Hace años escribí un post sobre el uso de Facebook como canal de atención de servicios públicos. Planteaba el caso de una señora que le reclama al Estado por Facebook porque no la atendieron bien por su diabetes, y me preguntaba qué iba a hacer la plataforma sabiendo eso. La autoridad a la que consulté me respondió hablando de cláusulas contractuales, y yo le insistía en que un contrato de adhesión no se negocia desde Chile. El informe de la Web3 Foundation responde esa pregunta con los documentos de las propias empresas: el 38% contempla recolectar datos sensibles, como salud, biometría, orientación sexual o religión, y tres de cada cuatro se reservan el derecho a inferir lo que el usuario no declaró.
Una historia larga en este blog
Llevo muchos años escribiendo sobre esto, y confieso que releer esos posts produce una mezcla de satisfacción y cansancio. Cuando escribí sobre cómo tratar la información de carácter personal, los principios básicos ya estaban claros: transparencia sobre qué se recolecta, propósito declarado, participación de las personas en el manejo de sus datos. Nada de eso era novedoso entonces y tampoco lo es ahora.
Después vinieron los casos concretos. El Estado mandándome correos masivos desde la Presidencia sin que yo hubiera dado mi dirección para eso. El proceso de compensación administrado por el SERNAC pidiendo datos sensibles sin explicar qué pasaría con esa base una vez terminado. El spammer que, cuando le pedí que me sacara de su lista, me exigió nombre, RUT y teléfono «por protocolo». En los comentarios de ese post escribí que lo de la ley de protección de datos parecía cuento, porque llevábamos cerca de una década discutiéndola. También cuestioné los rankings internacionales de ciberseguridad que ponían bien a un país sin ley de datos moderna.
La Ley 21.719 finalmente se publicó en diciembre de 2024, reemplazando la Ley 19.628 de 1999, que regía sin autoridad fiscalizadora propia y con multas simbólicas. En una columna en Ex-Ante sobre los desafíos de la nueva ley advertí que el pilar central era la Agencia de Protección de Datos Personales, y que armar una institucionalidad nueva desde cero es mucho más difícil de lo que parece en el papel.
Déjà vu: otra ley que se corre al 2027
Y aquí estamos. La Ley 21.719 debía entrar en vigencia el 1 de diciembre de 2026. El 1 de septiembre el Gobierno ingresó al Senado, con suma urgencia, un proyecto que la posterga hasta el 1 de diciembre de 2027 y que además modifica la estructura de la Agencia. Al momento de escribir esto, el Consejo Directivo de la Agencia todavía no se constituye, porque el Senado rechazó la primera propuesta de consejeros. Mientras el proyecto no se apruebe, la fecha legal sigue siendo diciembre de este año.
Hace unos meses, analizando la Ley 21.180 de Transformación Digital, escribí que una prórroga puede ser razonable si viene con recursos reales y un plan serio, y que lo problemático es correr el plazo sin resolver los problemas de fondo. Uno de los comentarios a dicho post decía: sin rediseño de fondo, vamos a ir saltando de prórroga en prórroga. Ahora tenemos dos leyes estructurales del Estado digital chileno con horizonte en 2027 y ambas con el mismo síntoma: la norma está escrita, la capacidad para cumplirla con serias dudas.
Lo he dicho en otras ocasiones: en tecnología, los reguladores tienden a quedar como espectadores con timbre. Mientras discutimos quiénes integran el consejo de la Agencia, cada televisor, cada auto conectado y cada aplicación de fidelización del retail sigue generando miles de registros diarios bajo reglas de 1999.
Lo que el informe enseña para Chile
Hay un hallazgo del estudio que me parece clave para nuestra discusión. Los hogares británicos, que viven bajo el GDPR del Reino Unido, uno de los marcos más exigentes del mundo, quedan vinculados a más organizaciones que sus pares en Estados Unidos. La regulación fuerte no reduce el volumen de datos que se generan. Lo que cambia es quién puede reutilizarlos, con qué reglas y qué camino tiene una persona para reclamar. En Estados Unidos, donde la protección depende del sector y del estado, el mismo dato de frecuencia cardíaca puede estar protegido en manos de un hospital y quedar a la intemperie en una aplicación de consumo.
La Ley 21.719 sigue la línea del modelo europeo, y eso está bien. Pero la ley por sí sola no protege a nadie. Lo que protege es una agencia con personas capaces de leer esos cinco millones de palabras de letra chica, de fiscalizar a grandes plataformas con equipos legales enormes y de sancionar cuando corresponde. Es exactamente la brecha que vengo describiendo con la 21.180: presupuesto, capital humano e infraestructura base.
Minimizar desde el diseño
El informe cierra con seis principios de diseño que recogen buena parte de lo que se discute hace años en el mundo de la identidad digital. Revelar solo lo necesario, por ejemplo acreditar que alguien es mayor de 18 años sin entregar su fecha de nacimiento. Dejar que las personas guarden sus propias credenciales verificables. Hacer que los permisos sean claros y fáciles de revocar. Responder una pregunta sin copiar todos los datos de fondo: un banco necesita saber que el ingreso supera cierto umbral, no dos años de cartolas. Permitir que los sistemas conversen sin facilitar el cruce de perfiles. Y proteger especialmente a quienes tienen menos margen para elegir, como niños y personas mayores.
Estás viendo un contenido de marcador de posición de Facebook. Para acceder al contenido real, haz clic en el siguiente botón. Ten en cuenta que al hacerlo compartirás datos con terceros proveedores.
Estás viendo un contenido de marcador de posición de Instagram. Para acceder al contenido real, haz clic en el siguiente botón. Ten en cuenta que al hacerlo compartirás datos con terceros proveedores.
Estás viendo un contenido de marcador de posición de X. Para acceder al contenido real, haz clic en el siguiente botón. Ten en cuenta que al hacerlo compartirás datos con terceros proveedores.